Видео с ютуба Ternary Llm

4 Bit Models Are DEAD | Ternary Models Are HERE!

What Are Ternary & 1-Bit AI Models Explained | Run AI With Almost No Memory

1-Bit LLM: The Most Efficient LLM Possible?

Why TERNARY LOGIC Makes More Sense Than Boolean Logic

Преодоление 1,58-битного барьера для тернарных LLM (сентябрь 2026 г.)

I Just Tried The Brand New Ternary Model And It's Great!

Преодолеваем барьер в 1,58 бита для тернарных LLM

BitNet b1.58 How 1.58-Bit Ternary Weights Run LLMs on CPUs Without GPUs
Сможет ли модель на 3.5 ГБ заменить мой основной инструмент на 35B? (Bonsai 27B)

Train Your Own Tiny LLM on Your PC In Just A Few Hours

Как LLM выживают в условиях низкой точности | Основы квантования

Ternary weights explained in 8min..

Ternary Mamba — Ternary Quantization-Aware Training (QAT), explained
The myth of 1-bit LLMs | Quantization-Aware Training

Ternary Computing Explained: Why Setun Lost in 1965 and Why AI Models Use Three States

BitNet b1.58 Explained: The 1-Bit Ternary LLM Revolution | AI Architecture
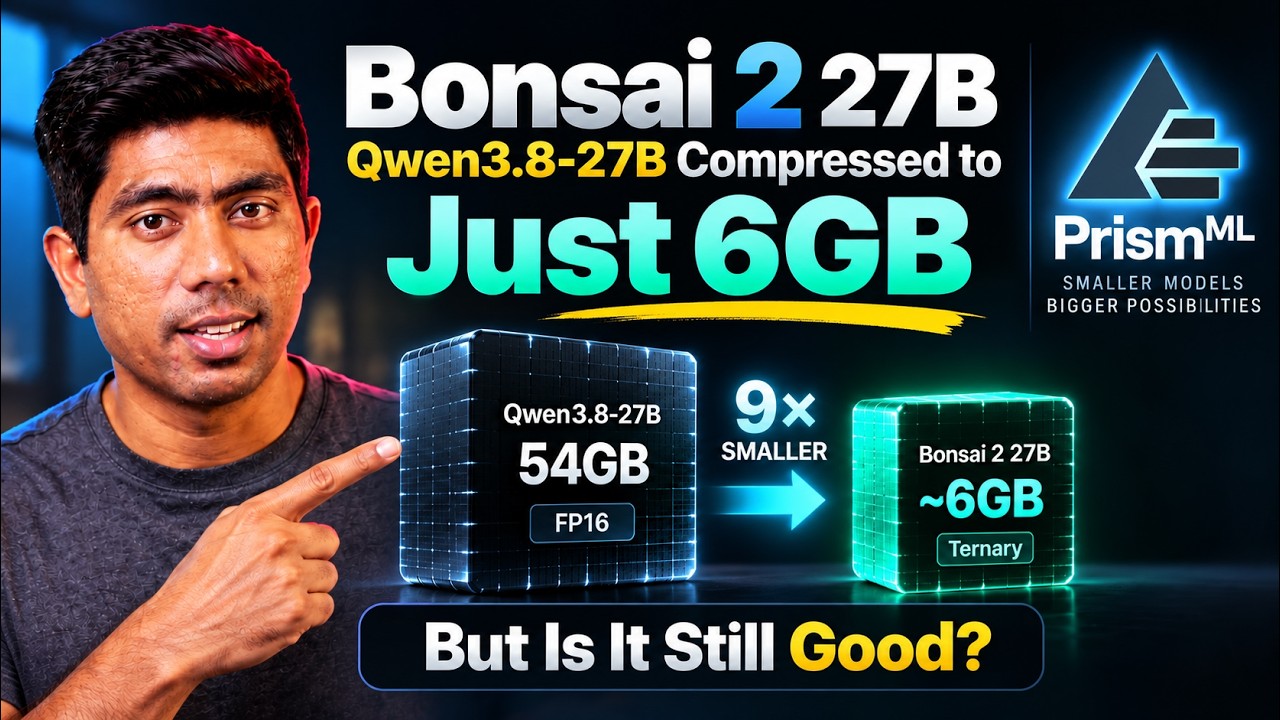
Bonsai 2 27B: Qwen3.8-27B, сжатая до 6 ГБ — но хороша ли она?

The End of GPU Dependency? Running Microsoft's 2B Parameter 1-Bit LLMs on a CPU! 🤯

Ternary Bonsai 27B против Qwen 3.6 27B: локальный тест, стоит ли экстремальное сжатие ИИ того?
Bonsai 27B Deep Dive – 1-Bit, Ternary & Full Precision Compared!